テストが遅い・CIが長い原因をAIと切り分ける|待ち時間を減らす手順
プッシュして、CIが回り始める。 コーヒーを淹れて戻ってきても、まだ黄色いまま。レビューの指摘を1行直して、またプッシュして、また待つ。1日のうち、待っている時間がけっこうある——そんな感覚、ありませんか。
「テストが遅いのは分かってる。でも、どこが遅いのかは測ったことがない」。現場ではよくあることです。忙しい中で後回しになるのは自然なことですし、あなたの段取りが悪いわけではありません。ただ、ここはAIが手伝いやすい所でもあります。この記事では、遅さを数字にして、AIと一緒に原因の型へ当てはめ、効く所から1つずつ直す手順を整理します。
結論:CIが遅いとき、いきなり「速くして」とAIに頼むより、先にどこに時間がかかっているかを測るほうが近道です。手順は3つ。①CI全体の時間を段取り(準備・ビルド・テスト)ごとに分け、テストは遅い順の上位10件を出す。②その数字をAIに渡し、遅さの5つの型(遅い一部のテスト/重い準備と後始末/CIの段取り/直列実行/毎回全部回す)のどれに当たるかと、直したときの効き目の見込みを出させる。③効き目が大きく、壊しにくい所から1つずつ直し、直す前と後で時間を比べる。テストを消したりスキップしたりして速くするのではなく、守りは残したまま待ち時間を削る。これが無理のない進め方です。
遅さは、たいてい少数の場所に集まっています。 全部を少しずつ速くする必要はなく、大きく時間を食っている数か所を見つけられれば十分です。今日は、その数か所を一緒に探していきましょう。
まず測る:CIの時間を「準備・ビルド・テスト」に分ける
最初にやるのは、直すことではなく、時間の内訳を出すことです。ここを飛ばすと、AIも人も「たぶんここだろう」で手を入れて、思ったほど速くならない——ということが起きがちです。
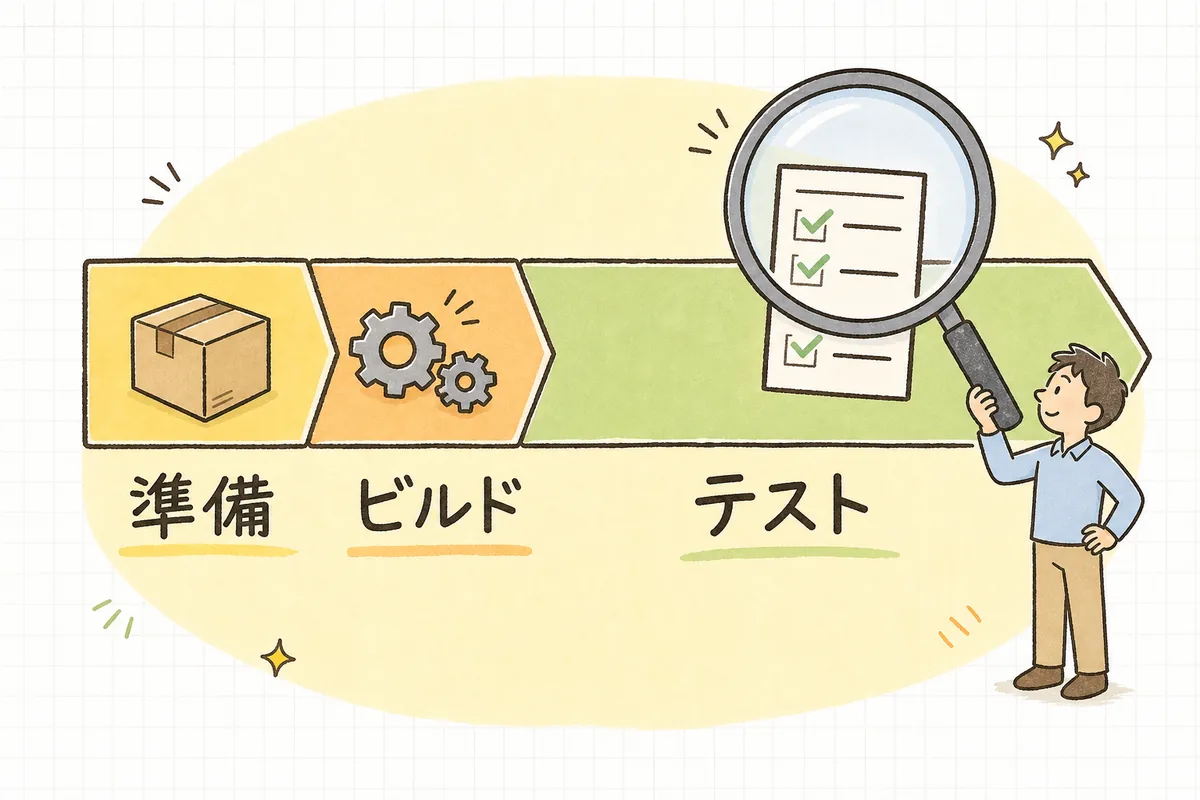
CIのログには、たいていステップ(段取り)ごとの所要時間が出ています。まずはそれを3つに分けて書き出します。
- 準備:依存ライブラリのインストール、コンテナやDBの起動など
- ビルド:コンパイル、バンドル、型チェックなど
- テスト:テストの実行そのもの
たとえば、こんな内訳になったとします。
CI全体:20分
  準備(依存のインストール):6分
  ビルド:3分
  テスト:11分
これだけでも見え方が変わります。テストだけを見ていたら気づかなかった「準備に6分」が浮かび上がる。もしかすると、テストより先に準備を短くしたほうが早く効くかもしれません。
次に、テストの中身を遅い順に並べます。多くのテストフレームワークには、時間のかかったテストを一覧にする機能があります(たとえばPythonのpytestなら --durations=10 で遅い順の上位10件が出ます)。使っている道具での出し方が分からなければ、それ自体をAIに聞けば大丈夫です。
使っているテストフレームワークは(名前とバージョン)です。
テストを1件ずつの所要時間つきで実行し、遅い順に上位10件を表示する方法を教えてください。
CIのログにも同じ一覧を残したいので、CI設定に足す場合の書き方もお願いします。上位10件を出してみると、ほんの数件が全体の大半を占めていることがよくあります。先の例で、テスト11分のうち上位10件で6分なら、テスト時間の半分強はその10件に集まっている計算です。数千件のテストを全部見直さなくていい。ここが分かるだけで、ずいぶん気が楽になります。
遅さの原因は、だいたい5つの型に収まる
数字が出たら、それを原因の型に当てはめていきます。CIやテストの遅さは、多くの場合この5つのどれか(またはその組み合わせ)です。
① 遅い一部のテスト sleep で固定時間待っている、本物の外部APIやネットワークに毎回つないでいる、大量のデータを毎回作っている。上位10件に同じ傾向のテストが並んでいたら、まずここです。
② 重い準備と後始末 テストのたびにDBを作り直す、毎回大きな初期データを流し込む、アプリ全体を起動し直す。1件ごとは数秒でも、件数を掛けると大きくなります。テスト本体より「前後」が重いパターンです。
③ CIの段取り 依存ライブラリを毎回ゼロからインストールしている、ビルド結果を使い回していない、大きなコンテナイメージを毎回取得している。「準備」の区間が長いなら、ここを疑います。 キャッシュ(前回の結果を保存して使い回す仕組み)が効いていないことが多いです。
④ 直列で回している テストを1本ずつ順番に流している。マシンには余力があるのに使い切っていない状態です。並列化で短くなる余地がありますが、後で触れるとおり並列化には注意点があります。
⑤ 毎回全部回している README を1行直しただけでも、全テストとE2Eまで毎回走る。変更と関係のない重いテストまで、毎回待っている状態です。
覚えるというより、測った数字を見ながら上から当てていくチェックリストとして使ってください。この当てはめを、次の手順でAIに手伝ってもらいます。
手順①:数字をAIに渡し、型と効き目の見込みを出させる
ここはAIの得意な所です。測った内訳と遅いテストの一覧を渡し、どの型に当たりそうか、直したらどのくらい効きそうかを整理してもらいます。
渡すと話が早いのは、次の4つです。
- CI全体の内訳(準備・ビルド・テストそれぞれの時間)
- 遅いテストの上位10件(名前と所要時間)
- 遅いテストのうち上位2〜3件のコード(テスト本体と、準備・後始末の部分)
- CI設定ファイル(キャッシュや並列の設定がどうなっているか分かる範囲で。認証情報やトークンが書かれている箇所は伏せてから渡す)
聞き方の例:
CIの所要時間を短くしたいです。まだコードは直さないでください。
下の計測結果をもとに、時間がかかっている原因を次の5つの型に分類してください。

① 遅い一部のテスト(sleep・外部通信・大量データ)
② 重い準備と後始末(毎回のDB作り直し・初期データ投入)
③ CIの段取り(依存インストール・ビルドの使い回し・キャッシュ)
④ 直列で回している
⑤ 変更に関係ないテストまで毎回回している

それぞれについて、
- そう判断した理由(計測結果のどこから読み取ったか)
- 直し方の候補
- 直したときに短くなりそうな時間の見込みと、その根拠
- 直すことで壊れやすくなる所(テストの信頼性への影響)
を挙げ、「効き目が大きく、壊しにくい順」に並べてください。
数字はこちらが渡した計測結果だけを根拠にし、推測の部分は推測と書いてください。

--- CI全体の内訳 ---
(貼る)
--- 遅いテスト上位10件 ---
(貼る)
--- 上位のテストコード ---
(貼る)
--- CI設定(秘密情報は伏せ済み) ---
(貼る)
ポイントは2つあります。 1つ目は、「直して」ではなく「分類して、順番をつけて」と頼むこと。いきなり修正を頼むと、AIは計測を見ないまま一般論の高速化(とりあえず全部並列にする、など)を返しがちです。 2つ目は、見込みの根拠を言わせること。「30%速くなります」のような数字が出てきても、それは見積もりです。どこから読み取った数字なのかを書いてもらえば、こちらで確かめる手がかりになります。AIの出す数字の扱いはAIにパフォーマンス改善の候補を出させる|推測で直さない手順の考え方とも同じです。
手順②:効き目が大きく、壊しにくい所から1つずつ直す
AIの整理が出たら、上から1つずつ直していきます。ここで大事なのは、一度に1つだけ直して、前後で時間を比べること。まとめて直すと、どれが効いたのか、どれが何かを壊したのかが分からなくなります。
型ごとの、比較的安全な直し方の向きは次のとおりです。
- ① 遅い一部のテスト → 固定の
sleepを「条件が満たされるまで待つ」書き方へ。外部APIは単体テストではモック(本物の代わりの偽物)に差し替え、本物につなぐテストは別枠に分ける。 - ② 重い準備と後始末 → 毎テストで作り直していた共通の準備を、テストのまとまりごとに1回へ寄せる。DBは作り直す代わりに、トランザクションを巻き戻して元に戻す方法が使えないか検討する。ただし、準備を共有するとテスト同士が影響し合いやすくなるので、後始末が確実か必ず確認する。
- ③ CIの段取り → 依存ライブラリやビルド結果をキャッシュして使い回す。多くのCIサービスにキャッシュの仕組みがあるので、使っているサービスの公式ドキュメントで書き方を確認する。テストのコードを触らずに済むので、いちばん壊しにくい改善であることが多いです。
- ④ 直列で回している → テストを並列で走らせる(pytestなら pytest-xdist などのプラグイン、他のフレームワークにも並列実行の設定があります)。並列にした途端、共有しているDBやファイルを取り合ってたまに落ちるテストが出ることがあります。 並列化の前後では、たまに落ちるテスト(Flaky)の原因をAIに切り分けさせる手順の連続実行で、落ちる頻度が増えていないかを確かめておくと安心です。
- ⑤ 毎回全部回している → 変更したファイルに応じて走らせるテストを絞る、重いE2Eはマージ前や夜間にまとめて回す、などの分け方を検討する。どこまで絞るかはチームで合意してからにします。
そして直すたびに、最初に測った数字と比べます。
直す前:CI全体 20分(準備 6分 / ビルド 3分 / テスト 11分)
キャッシュ導入後:CI全体 _分(準備 _分 / ビルド _分 / テスト _分)キャッシュは2回目以降の実行で効いてくるものなので、1回だけでなく数回分を見て判断するのがおすすめです。CIの時間はその日の混み具合でもぶれるので、1回の結果で一喜一憂しないくらいがちょうどいいです。
ありがちな落とし穴と、その回避
遅さをAIと一緒に削るとき、つまずきやすい所を先に置いておきます。
- 測らずに直し始める:効きそうな所を勘で直して、ほとんど変わらない。まず内訳と上位10件を出してから。
- テストを消す・スキップして速くする:時間は減っても、守りが減っています。消すなら「なぜ不要か」をチームで確認してから。遅いテストは、まず速くできないかを考えます。
- 一度にまとめて直す:どれが効いたか、どれが壊したかが分からなくなる。1つずつ直して、前後を比べる。
- 並列化してFlakyを増やす:速くなった代わりに、たまに落ちるテストが増えては本末転倒。並列化の前後で落ちる頻度も見る。
- AIの見込みの数字をそのまま報告する:「30%短縮見込み」は推測。報告するのは、実際に測った前後の数字にする。
- CI設定を秘密情報ごとAIに貼る:トークンや認証情報は伏せてから渡す。
落とし穴の多くは、「早く速くしたい」気持ちから、測る・比べるを飛ばす所で生まれます。 測る一手を挟むだけで、遠回りに見えて、いちばん早く待ち時間が減ります。
明日からやること(小さく始める3つ)
全部を一度にやらなくて大丈夫です。まずはこの3つから。
- CIのログから、準備・ビルド・テストの時間を書き出す:5分で終わります。それだけで「どこが重いか」の見当がつきます。
- 遅いテストの上位10件を出してみる:出し方が分からなければAIに聞けば大丈夫です。数件に偏っていないかを見ます。
- その2つをAIに渡し、5つの型への分類と「効き目が大きく、壊しにくい順」を出してもらう:いちばん上の1つだけ、まず試してみます。
この3つで、「なんとなく遅い」が「ここが何分かかっている」に変わります。そこまで来れば、もう半分は解けたようなものです。
コピーして使う「CIの遅さ切り分けシート」
CIが遅いと感じたら、上から順に埋めてください。分かる所からで十分です。
# CIの遅さ 切り分けシート

## 1. 測る
- [ ] CI全体:_分
- [ ] 準備(依存インストール・コンテナ起動):_分
- [ ] ビルド:_分
- [ ] テスト:_分
- [ ] 遅いテスト上位10件を出した(合計_分 / テスト全体の_%)

## 2. 型に当てはめる(AIと一緒に)
- [ ] ① 遅い一部のテスト(sleep・外部通信・大量データ)
- [ ] ② 重い準備と後始末(毎回のDB作り直し・初期データ)
- [ ] ③ CIの段取り(キャッシュ・ビルドの使い回し)
- [ ] ④ 直列で回している
- [ ] ⑤ 変更に関係ないテストまで毎回回している

## 3. 1つずつ直す
- [ ] 効き目が大きく、壊しにくい順に並べた
- [ ] 一度に直すのは1つだけにした
- [ ] テストを消す・スキップする以外の手を先に考えた
- [ ] CI設定をAIに渡すとき、秘密情報を伏せた

## 4. 比べる
- [ ] 直す前と後の時間を、数回分で比べた
- [ ] 並列化した場合、たまに落ちるテストが増えていないか確かめた
- [ ] 報告には、見込みではなく実測の前後を書いた
最後に
CIを待つ時間は、1回ずつなら数分です。 でも、それが1日に何度も、チーム全員に積み重なっている。そこに気づいて「少しでも短くしたい」と思えるのは、自分の時間だけでなく、チームの時間も大事にしているからです。それは、ちゃんと価値のある仕事です。
一度に何十分も削らなくて大丈夫です。今日は、CIのログから3つの時間を書き出すだけ。数字が見えれば、AIは頼もしい相談相手になってくれます。測るのはあなた、型に当てはめて順番を考えるのはAIと一緒に。その分担で、待ち時間は少しずつ、確実に短くなっていきます。
よければ、こちらも
- たまに落ちるテストが気になったら たまに落ちるテスト(Flaky)の原因をAIに切り分けさせる手順
- アプリ側の遅さを直すなら AIにパフォーマンス改善の候補を出させる|推測で直さない手順
- CIで使うコンテナが重いときは AIに書かせたDockerfile|イメージ肥大と脆弱性の確認
- 短縮の成果を伝えるなら 「で、効果あったの?」AI活用の成果を数字で報告するコツ